Update2026.11.06 (금)

응급실에서 환자의 상태를 신속히 판단해 치료 우선순위를 정하는 ‘중증도 분류’를 지원하는 인공지능(AI) 모델이 국내 연구진에 의해 개발됐다. 실제 환자와 의료진 간 대화를 학습한 모델로, 기존 AI 대비 높은 정확도를 보인 것이 특징이다.
고려대학교 안산병원 응급의학과 이수교 교수와 고려대학교 의과대학 통일한국보건의학연구소 정수민 교수 연구팀은 응급실 대화를 기반으로 환자 중증도를 분류하는 AI 모델을 개발했다고 밝혔다.
이번 연구는 「Development of BERT-based large language models for emergency department triage using real-world conversations」라는 제목으로 국제 학술지 Journal of the American Medical Informatics Association에 게재됐다.
응급실에서의 중증도 분류는 환자의 생존율과 직결되는 핵심 과정이다. 국내에서는 한국형 응급환자 분류도구(KTAS)를 활용해 환자를 1~5단계로 구분하며, 심정지나 쇼크 환자는 즉시 최우선 치료 대상이 된다.
문제는 즉각적인 생명 위협은 없지만 치료가 필요한 중간 단계 환자를 구분하는 과정이다. 특히 KTAS 3단계와 4~5단계 환자를 나누는 기준은 검사 수치보다 환자와의 대화, 통증 양상, 증상 경과 등 정성적 판단에 크게 의존해 의료진의 부담이 컸다.
연구팀은 이러한 한계를 극복하기 위해 실제 응급실 대화를 학습 데이터로 활용했다. 국내 3개 상급종합병원에서 수집된 5,244건의 임상 대화 중 중증도 분류 관련 1,057건을 선별해 모델을 훈련시켰다.
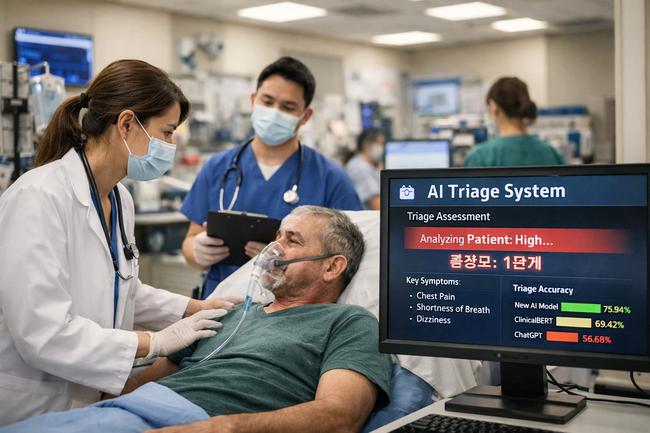
그 결과, 해당 AI 모델은 정확도 75.94%를 기록해 기존 범용 AI 모델인 ChatGPT(56.68%)와 의료 특화 모델 ClinicalBERT(69.42%)보다 높은 성능을 보였다. 특히 긴급 환자를 놓치지 않는 능력을 의미하는 재현율은 0.9610으로, ChatGPT(0.5352)를 크게 웃돌았다.
이는 실제 응급 환자의 약 96% 이상을 정확히 식별할 수 있음을 의미하며, 응급실 현장에서의 활용 가능성을 보여주는 지표로 평가된다.
기존 의료 AI 모델들이 구조화된 데이터나 요약된 임상 시나리오 중심으로 학습된 것과 달리, 이번 연구는 실제 환자-의료진 대화를 반영했다는 점에서 차별성을 가진다. 환자의 표현 방식과 의료진의 질문 흐름 등 현실 진료 상황을 반영해 보다 정밀한 판단이 가능해졌다는 설명이다.
다만 실제 의료 현장 적용을 위해서는 추가 검증과 다양한 환자군 데이터 확보가 필요하다는 지적도 나온다. 전문가들은 AI가 의료진을 대체하기보다는 판단을 보완하는 역할로 자리 잡을 것으로 보고 있다.
의료계에서는 이번 연구가 응급의료 시스템의 디지털 전환을 앞당기는 계기가 될 것으로 기대하고 있다. 특히 대화 기반 AI의 임상 적용 가능성을 입증했다는 점에서 의미가 크다는 평가다.